山西作为国家资源型经济转型综改试验区,近年来数据中心建设速度明显加快。据山西省通信管理局公开数据,截至2024年底,全省在用标准机架数已突破12万架,较2020年增长近三倍。机架规模上去了,运维能力能不能跟上,成为摆在众多政企用户面前的一道现实考题。笔者在山西本地从事IT基础设施运维服务多年,结合项目实践与行业观察,谈几点关于数据中心运维的思考。
一、山西数据中心运维的特殊性在哪里
与北上广深不同,山西的数据中心运维面临几个绕不开的现实条件。其一是气候因素:冬季漫长、温差大,对机房精密空调的制冷策略和室外机防冻提出更高要求;其二是电力结构:部分地市供电稳定性存在波动,UPS和柴发的切换逻辑需要针对本地电网特征做定制化调优;其三是人才分布:高端运维工程师集中在太原,地市级机房往往面临“设备到位、人跟不上”的窘境。
这些因素叠加,决定了山西的数据中心运维不能简单照搬一线城市的标准化方案。比如大同某政务云机房,2023年冬季因室外机化霜逻辑缺陷导致冷通道温度短时超标,事后复盘发现,问题根源在于空调厂商的默认参数未考虑当地极端低温工况。这类案例说明,本地化运维经验的积累,在山西市场具有实实在在的价值。
二、运维外包的边界:哪些能包,哪些不能包
机房运维外包在山西的接受度逐年提高,但不少用户对“外包什么”缺乏清晰认知。实践中较为合理的分工是:基础设施层(供配电、制冷、消防、动环监控)整体外包给专业服务商,网络与安全设备维保按厂商授权体系走,而业务系统的数据库运维和中间件调优,则适合采用“驻场工程师+远程专家”的混合模式。
以我们服务过的一家省属国企为例,其数据中心原有3名自有运维人员,日常疲于应对巡检和故障报修,核心的数据库性能优化和灾备演练长期搁置。引入驻场运维工程师后,基础巡检和一线响应由驻场人员承担,数据库运维和灾备方案设计由后端专家团队支撑,自有人员则转向架构规划和业务对接。运行一年后,该机房MTTR(平均修复时间)从47分钟降至19分钟,灾备切换演练成功率从60%提升至100%。
三、监控平台不是万能药,数据治理才是关键
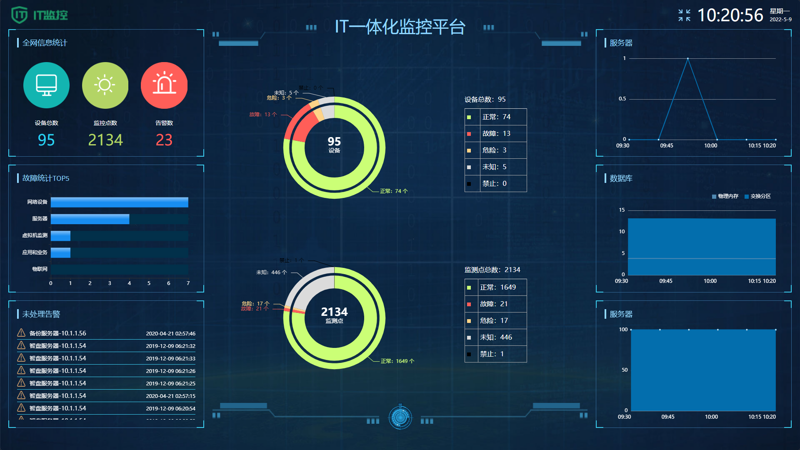
走访山西多家数据中心后发现一个共性现象:动环监控、网络管理、APM工具大多上了,但告警风暴依然存在,运维人员每天收到数百条告警,真正需要处理的被淹没其中。问题的症结不在工具本身,而在告警策略的精细化治理。
有效的做法是建立三级告警收敛机制:第一级做阈值动态基线,避免固定阈值在业务高峰期的误报;第二级做关联分析,将同一根因引发的多条告警合并;第三级做告警分级与值班路由,P1级直接电话触达,P3级进入工单池。这套机制在晋中某互联网企业的机房落地后,日均告警量从420条压缩到35条左右,运维人员的有效工作时间占比提升了近四成。
四、灾备建设:从“有”到“有用”还有多远
山西不少政企单位已完成灾备系统的初步建设,但“建而不用、用而不验”的情况并不少见。灾备方案的价值不在纸面文档,而在真实切换能力。建议至少每季度做一次非破坏性切换演练,每半年做一次全流程实战演练,并将演练结果纳入运维KPI考核。同时,灾备演练应覆盖数据库一致性校验、网络路由切换、DNS解析切换等关键环节,避免出现“主机切过去了、数据没跟上”的尴尬局面。
说到底,山西数据中心运维正处在从“被动响应”向“主动治理”过渡的阶段。无论是机房运维外包、驻场工程师配置,还是运维监控平台的建设,最终都要落到一个问题上:故障发生前,我们能不能提前看见?这个问题的答案,决定了运维工作的真正成色。